[AI] 6. Hyperparameter Optimization. Grid Search부터 BOHB 까지
하이퍼파라미터 최적화에 대해 알아보자.
하이퍼파라미터(Hyperparameter)란?
신경망의 가중치, 편향과 같이 데이터를 학습하는 과정에서 모델이 스스로 값을 찾아내는 매개변수가 아니라 학습률, 배치 크기처럼 학습을 시작하기 전에 사람이 직접 지정해주어야 하는 값이다.
1. 검증 데이터 (Validation Data)
하이퍼파라미터의 적절한 값을 찾기 위해 사용되는 데이터이다.
- 훈련 데이터 (Training Data) : 모델이 가중치, 편향 같은 매개변수를 학습하는데 사용되는 데이터
- 검증 데이터 (Validation Data) : 학습률, 배치 크기와 같은 하이퍼파라미터를 튜닝하는데 사용되는 데이터
- 시험 데이터 (Test Data) : 신경망의 성능을 평가하기 위한 데이터
이와 같이 데이터들을 분류하는 이유는, 각 매개변수와 하이퍼파라미터에 대해 과적합(Overfitting)이 일어나는 것을 막고 새로운 데이터에 대해서도 정확하게 작동하는지 평가하기 위해서 이다.
MNIST 처럼 훈련/시험 데이터만 주어지는 경우 훈련 데이터의 일부를 검증 데이터로 분리한다. 보통 20%정도를 사용한다.
2. Grid Search
하이퍼파라미터의 탐색 범위를 일정한 간격으로 나누어 규칙적으로 탐색하는 방법이다.
지정한 후보군 내에 최적의 값이 있다면 반드시 찾아내지만 탐색해야할 하이퍼파라미터가 많을 수록 계산량과 시간이 기하급수적으로 증가한다.
즉, 하이퍼파라미터의 수가 적은 간단한 모델에는 효과적인 방법이 될 수 있지만 반대의 모델에는 비효율적이다.
3. Random Search
대략적인 범위를 설정하고 그 범위 안에서 무작위로 하이퍼파라미터 값을 추출하여 평가하는 기법이다.
탐색 공간이 넓을 때는 그리드 서치보다 훨씬 적은 시간과 비용으로 좋은 성능의 조합을 찾아낼 수 있다. 그러나 무작위로 선택하기 때문에 최적의 해는 보장하지 않을 수 있다.
탐색 범위는 0.001, 100과 같이 10의 거듭제곱인 로그 스케일(Log Scale)을 이용하는 것이 효과적이다.
탐색 과정이 매우 오래 걸리므로 에폭 크기를 작게 설정하여 평가 시간을 단축시킨다.
- 0단계 : 하이퍼파라미터 값의 범위를 설정한다.
- 1단계 : 설정된 범위 내 무작위 추출한다.
- 2단계 : 샘플링한 하이퍼파라미터로 학습, 검증데이터로 정확도를 평가한다.
- 3단계 : 1~2 단계를 반복하여 하이퍼파라미터 값의 범위를 축소한다.
4.베이지안 최적화 (Bayesian Optimization)
신경망에서 하이퍼파라미터 학습의 검증 정확도를 얻는 과정은 미지의 블랙박스 함수를 푸는 것과 같다.
블랙박스 함수(Black box function)란?
내부 구조나 작동 원리를 알 수 없거나 고려하지 않고, 오직 입력(Input)과 출력(Output)의 관계만을 통해 다루는 함수이다.
베이지안 최적화는 이 함수의 평가 횟수를 최소화하면서 최적값을 똑똑하게 찾기 위한 목적을 가지고 있다.
대체 모델 : 주로 가우시안 프로세스(Gaussian Process)를 이용한다. 지금까지 관측된 하이퍼파라미터 조합과 성능 데이터를 바탕으로 아직 시도하지 않은 공간에 대한 확률적 지형을 만든다.
임의의 하이퍼파라미터에 대해 기댓값 $\mu$과 분산 $\sigma^2$을 반환하는 역할을 한다.
획득 함수 (Acquisition Function) : 대체 모델의 평균과 분산으로 다음에 어떤 하이퍼파라미터를 평가하는 것이 효율적일지 계산하는 함수이다.
베이지안 최적화에 대한 자세한 내용은 다음 글에 다뤄보도록 하겠다.
4.Successive Halving Algorithm (SHA)
딥러닝 모델 학습에는 많은 Budget(에폭, 데이터크기, 반복 횟수 등 연산 자원)이 소모된다.
Grid Search나 Random Search와 같은 방법은 성능이 안 좋을 것 같아도 학습을 끝까지 돌려 자원낭비 현상이 발생한다.
SHA는 성능이 나쁜 조합을 절반 정도 미리 탈락시키고 살아남은 좋은 조합에 2배의 자원을 주어 학습을 시키는 과정을 반복하여 좋지 않은 조합의 후보에 자원이 낭비되는 현상을 예방한다.
다만 초기에 성장이 느려도 나중에 성능이 좋아지는 좋은 조합이 탈락될 수 있다는 단점이 있다.
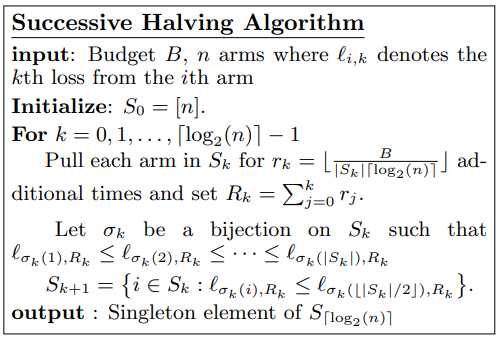
여기서 arm은 $n$개의 서로 다른 하이퍼파라미터 조합을 의미한다.
ex) Arm 1 = {학습률 0.01, 배치크기 32}, Arm 2 = {학습률 0.001, 배치크기 64}
Pull each arm 이라는 표현은 해당 하이퍼파라미터 조합으로 모델을 일정 에폭만큼 실제로 학습시킨다는 뜻이다.
$n, B$를 어떻게 설정하느냐에 따라 결과가 달라질 수 있다. $n$을 너무 크게 잡으면 예산 $r$이 극단적으로 작아져 잠재력은 높은 좋은 모델이 우연히 1라운드에서 탈락할 위험이 있다.
이러한 SHA의 단점을 보완하기 위해 나온 알고리즘이 Hyperband이다.
4.Hyperband
Successive Halving Algorithm (SHA)알고리즘으로 부터 나온 알고리즘이다.
다음과 같은 전략에 대해 생각해보자.
- A : 100개의 조합을 뽑고 각각 1 에폭씩 학습시킨 뒤 하위 50개 버리기
- B : 10개의 조합을 뽑고 각각 10에폭씩 학습시킨 뒤 하위 5개 버리기
두 전략 모두 동일하게 100의 에폭을 사용하지만 장단점이 명확하다. A는 많은 조합을 탐색할 수 있되, 학습이 느린 하이퍼파라미터가 1에폭만 조사했기 때문에 억울하게 탈락될 수 있다. 반대로 B는 좀 더 안정적으로 평가할 수 있지만 탐색 범위가 너무 좁아진다.
Hyperband는 A, B 세팅 둘 다 다르게 만들어서 전체 자원을 Bracket(그룹)으로 쪼갠 뒤 서로 다른 세팅의 SHA를 적용하는 아이디어이다.
간단하게 설명하면 다음과 같다.
- Bracket 3 : 많은 조합을 뽑고 아주 미미한 자원을 준 뒤 빠르게 탈락시킨다.
- Bracket 2~1 : 중간 정도의 조합을 뽑고 중간 정도의 자원을 줘서 탈락시킨다.
- Bracket 0 : 적은 조합을 뽑고 많은 자원으로 학습시킨다.
Random Search와 동일하다.
이 모든 결과 중 가장 손실이 적은 하이퍼파라미터 조합을 선택한다.
그러나 이전 Bracket에서 실패했던 좋지 않은 조합들을 다음 Bracket에서 또 무작위로 뽑아 자원낭비가 될 수 있다.
5. BOHB (Bayesian Optimization and Hyperband)
BOHB 알고리즘은 이름에서 알 수 있듯이 베이지안 최적화와 Hyperband를 결합한 최적화 기법이다.
Hyperband: 초기에 수많은 하이퍼파라미터 조합을 Successive Halving를 통해 가망 없는 모델의 학습을 중단 시켜 자원 낭비를 줄이지만 초기 후보를 추출할 때 Random Search에 의존하기 때문에, 이전 단계에서 얻은 학습 데이터를 다음 후보 생성에 전혀 활용하지 못한다는 단점이 있다.
베이지안 최적화: 관측된 데이터를 바탕으로 대체 모델을 만들고 획득 함수를 통해 가장 성공 가능성이 높은 다음 조합을 찾는다. 하지만 모든 후보를 끝까지 학습시켜야 하므로 탐색 속도가 느리며, 자원 낭비가 발생할 수 있다.
BOHB는 Hyperband의 틀은 유지하고 후보를 생성하는 방식을 Random Search에서 베이지안 최적화로 대체한 알고리즘이다.